Une étude publiée le 29 octobre dans Nature Medicine évalue EVLF-FM, un modèle d’intelligence artificielle capable d’analyser plusieurs types d’images médicales et d’indiquer les zones qui étayent ses réponses. Ses résultats sur des jeux de données indépendants sont prometteurs, mais les chercheurs soulignent qu’une validation clinique supplémentaire reste indispensable.
Imagerie médicale : une IA localise les anomalies, mais ses explications ne suffisent pas encore au diagnostic
By
Published on 30 octobre 2026 22h16
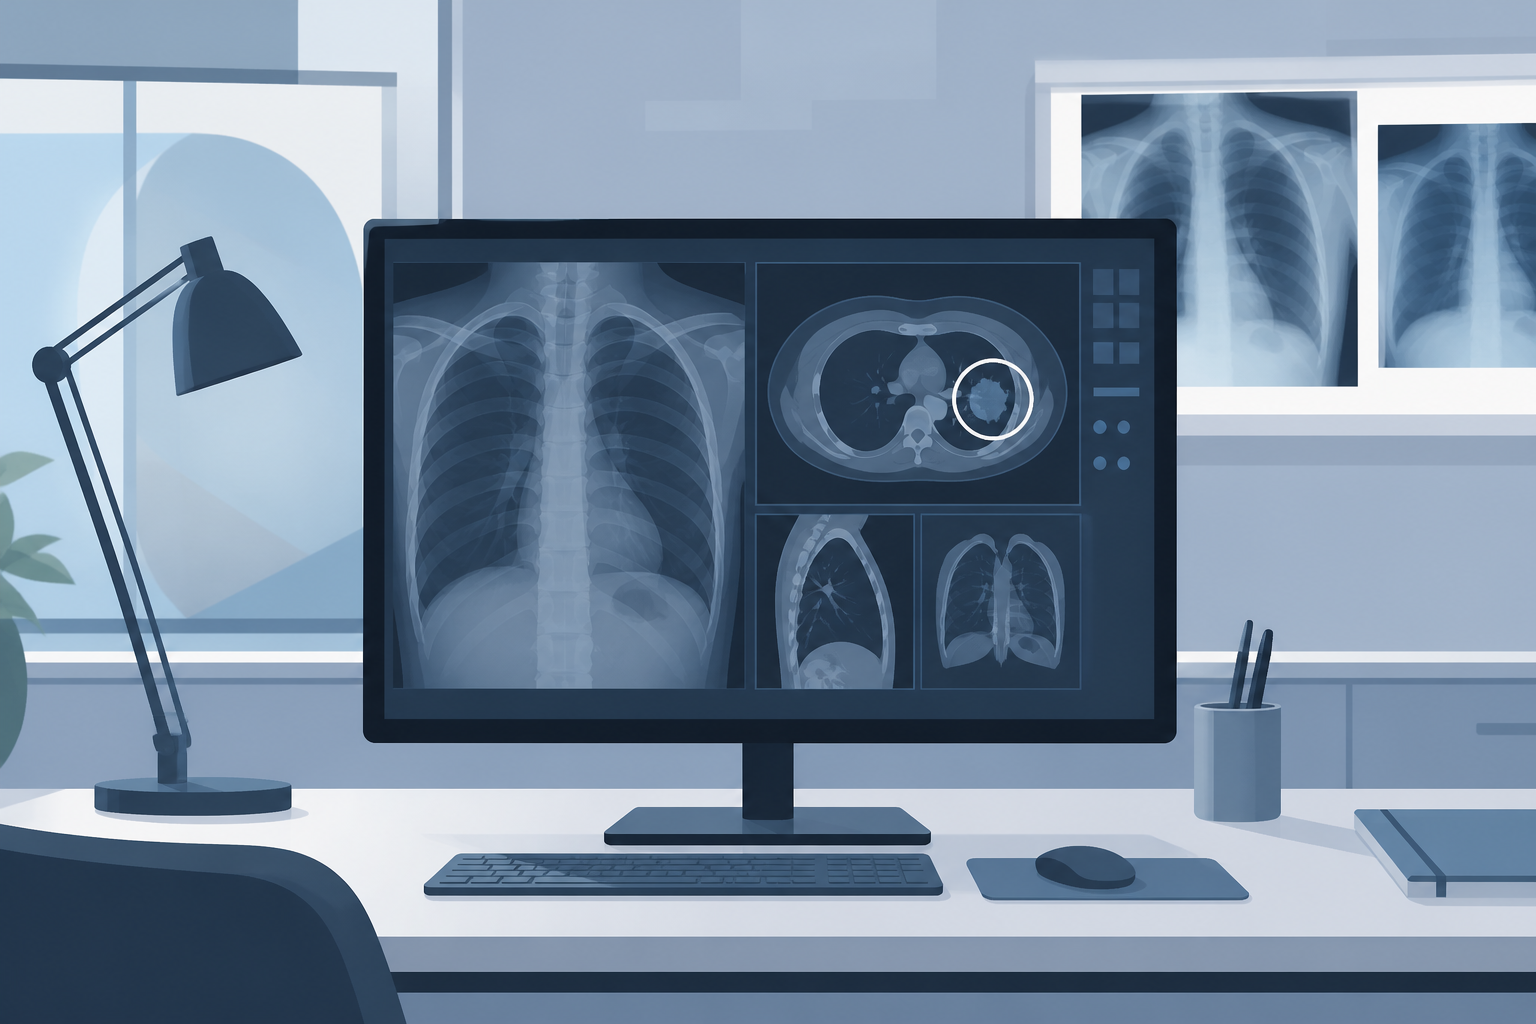
Une intelligence artificielle capable de commenter une image médicale et de désigner précisément la région qui motive son interprétation : c’est l’objectif d’EVLF-FM, évalué dans une étude publiée le 29 octobre 2026 dans Nature Medicine. Le modèle ne se limite pas à classer une image dans une catégorie diagnostique. Il peut également répondre à des questions et localiser des signes visuels, ce qui pourrait aider les professionnels à vérifier ses propositions.
Dix modalités d’imagerie et six spécialités médicales
Le développement et les tests du modèle ont mobilisé plus de 1,3 million d’échantillons, couvrant notamment radiographies, scanners, IRM, échographies, photographies du fond d’œil, examens de rétine par tomographie à cohérence optique, images de pathologie et dermoscopie. Les travaux concernent six domaines, de la radiologie à la dermatologie, en passant par l’ophtalmologie.
Les chercheurs ont également procédé à une validation externe sur 13 443 échantillons provenant de 17 autres ensembles de données, afin de tester le système sur des images distinctes de celles utilisées pour son développement. Ce contrôle est essentiel : une IA peut afficher de très bons résultats sur des bases familières sans reproduire les mêmes performances dans d’autres hôpitaux ou sur d’autres appareils.
Dans les évaluations internes de classification diagnostique, EVLF-FM a atteint une exactitude moyenne de 89,5 %, supérieure à celle des modèles comparés sur cet ensemble de tâches. Mais cette moyenne ne représente ni un taux de diagnostic correct pour tous les patients ni une performance identique pour toutes les maladies. Lors des tests externes, les résultats ont varié selon les examens : sur un ensemble de tomographies rétiniennes, l’exactitude sans exemples supplémentaires n’était que de 50,3 %, contre des performances nettement plus élevées sur certains examens thoraciques.
Montrer la zone suspecte ne prouve pas le raisonnement de la machine
L’originalité du système réside dans l’association d’une réponse textuelle et d’un repérage visuel des régions pertinentes. Le modèle peut, par exemple, associer une anomalie décrite à une zone de l’image. Sur un ensemble d’évaluations internes de localisation, il atteint une moyenne de 84,2 % pour la métrique retenue par les auteurs, fondée sur un recouvrement suffisant entre zone prédite et annotation de référence.
Douze médecins, dont huit spécialistes, ont aussi évalué les explications produites. La note moyenne atteint 4,25 sur 5 selon leur grille d’appréciation. Certains experts ont toutefois signalé des observations secondaires manquantes, notamment sur des images de rétine. Une explication cohérente et convaincante ne garantit donc pas que le système a réellement fondé sa décision sur les éléments qu’il met en avant : les auteurs décrivent eux-mêmes ces explications comme produites a posteriori.
La présentation indépendante de ces résultats souligne également la distinction entre les performances sur bases de test et l’usage auprès de patients réels. Le travail a été publié dans une revue scientifique évaluée par les pairs ; il ne s’agit pas d’un essai clinique démontrant une amélioration des soins.
Un outil de recherche, pas un lecteur autonome d’examens
Les chercheurs reconnaissent que l’exactitude du modèle n’atteint pas systématiquement le niveau requis pour une utilisation clinique directe. Ses réponses aux questions ouvertes sont moins solides que ses classifications, et les performances peuvent dépendre des populations, des appareils et de la représentativité des données. Une partie des bases utilisées est par ailleurs soumise à des restrictions d’accès liées aux données médicales.
Pour les patients, aucun changement immédiat du parcours de soins ne découle de cette publication. Les examens restent à interpréter dans leur contexte médical par des professionnels qualifiés. La perspective étudiée est celle d’une aide à la lecture et à la vérification des images, qui devra encore être évaluée en situation réelle, notamment pour mesurer les erreurs, les biais et l’effet sur les décisions des soignants.